Domain our-song.de kaufen?
Wir ziehen mit dem Projekt
our-song.de um.
Sind Sie am Kauf der Domain
our-song.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain our-song.de kaufen?
Wie nutzt man Windows Speech Recognition richtig in Visual Basic?
Um Windows Speech Recognition in Visual Basic zu nutzen, müssen Sie zunächst sicherstellen, dass Sie die entsprechenden Verweise auf die Speech API in Ihrem Projekt hinzugefügt haben. Dann können Sie die SpeechRecognitionEngine-Klasse verwenden, um Spracheingaben zu erkennen und zu verarbeiten. Sie können Ereignisse wie SpeechRecognized und SpeechRecognitionRejected abonnieren, um auf erkannte oder abgelehnte Spracheingaben zu reagieren. Schließlich können Sie die RecognizeAsync-Methode aufrufen, um die Spracherkennung zu starten und auf Benutzereingaben zu warten. **
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
Ähnliche Suchbegriffe für Speech recognition
Top-Angebote
Produkte zum Begriff Speech recognition:
-
Smart Speech, Fachbücher von Peter FlumeEinen überzeugenden Vortrag zu erstellen, ist oft mit einem hohen Zeitaufwand verbunden. Durch den gezielten Einsatz von Künstlicher Intelligenz lässt sich die Vorbereitungszeit jedoch um bis zu 75 % reduzieren und die Qualität der Präsentationen gleichzeitig spürbar verbessern. In diesem Buch von Peter Flume wird erklärt, wie KI-Agenten mit rhetorischen Grundlagen so trainiert werden können, dass sie individuelle und überzeugende Redemanuskripte erstellen, in denen die eigene Rednerpersönlichkeit erhalten bleibt. Darüber hinaus werden die Grenzen der KI beleuchtet und aufgezeigt, wie diese produktiv genutzt werden können und wie KI auch bei fremdsprachigen Präsentationen eine wertvolle Hilfe ist. Die vorgestellten Methoden sind direkt anwendbar und praxisnah. Inhalte: - KI nutzen für mehr Überzeugungskraft: schnelle Strukturierung, sprachliche Optimierung, inhaltliche Tiefe - Effiziente Workflows mit KI-Tools entwickeln und einsetzen - Inhalte mithilfe von KI zielgruppenorientiert aufbereiten - Anpassung generierter Texte an den eigenen Redestil - Gezielte Vorbereitung auf Rückfragen und Einwände - Wirkung vor Publikum steigern durch Sprache und Körpersprache - Souveräner Umgang mit Rückfragen und kritischen Situationen - Aufmerksamkeit sichern durch spannende Titel und Dramaturgie - Unterschiedliche Erzählhaltungen für verschiedene Publikumstypen einsetzen - Schlagfertigkeit und Deeskalation trainieren.29,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Wie erstelle ich ein eigenes Text-to-Speech-Paket?
Um ein eigenes Text-to-Speech-Paket zu erstellen, benötigst du zunächst eine Sprachsynthese-Engine, die den Text in Sprache umwandelt. Du kannst eine vorhandene Engine verwenden oder eine eigene entwickeln. Anschließend musst du die Sprachdatenbank erstellen, die die Aufnahmen der Sprachausgabe enthält. Diese Datenbank kann aus Aufnahmen eines Sprechers bestehen oder durch die Kombination von vorhandenen Sprachdatenbanken erstellt werden. Schließlich musst du das Paket in einem geeigneten Format speichern, das von der gewünschten Plattform oder Anwendung unterstützt wird, z.B. als Plugin, Bibliothek oder Datei. **


Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
Top-Angebote
Produkte zum Begriff Speech recognition:
-
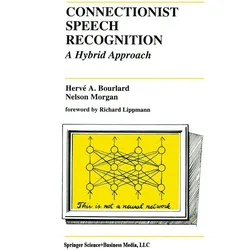
Connectionist Speech Recognition, Fachbücher von Hervé A. Bourlard, Nelson MorganDas Fachbuch "Connectionist Speech Recognition" bietet eine umfassende Analyse der Integration von neuronalen Netzwerken in moderne Spracherkennungssysteme, die auf versteckten Markov-Modellen (HMMs) basieren. Verfasst von den Experten Hervé A. Bourlard und Nelson Morgan, beschreibt das Buch sowohl die theoretischen Grundlagen als auch die praktischen Implementierungen dieser hybriden Ansätze. Es beleuchtet die Erfolge und Herausforderungen, die während einer fünfjährigen internationalen Zusammenarbeit der Autoren auftraten, und bietet wertvolle Einblicke in die Entwicklung von Systemen, die neuronale Netzwerke mit traditionellen statistischen Methoden kombinieren. Durch den Einsatz standardisierter Datenbanken wird demonstriert, wie die Schätzung von Wahrscheinlichkeiten durch multilayer perceptrons (MLPs) die Erkennungsleistung signifikant verbessern kann. Das Buch ist eine wertvolle Ressource für Fachleute und Studierende, die sich mit den neuesten Entwicklungen in der Spracherkennungstechnologie auseinandersetzen möchten.182,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
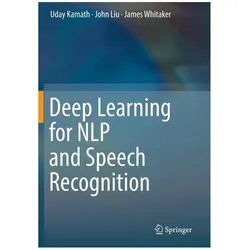
Deep Learning for NLP and Speech Recognition, Fachbücher von Uday KamathDas Fachbuch "Deep Learning for NLP and Speech Recognition" bietet eine umfassende Einführung in die Architektur des Deep Learning und deren Anwendungen in verschiedenen Aufgaben der natürlichen Sprachverarbeitung sowie der Spracherkennung. Es adressiert die wachsende Nachfrage nach einem einheitlichen Nachschlagewerk, das die Techniken des Deep Learning mit praktischen Anwendungen in Bereichen wie Finanzen, Gesundheitswesen und Regierung verknüpft. Das Buch behandelt aktuelle Methoden des Deep Learning, die für NLP und Sprachanwendungen relevant sind, und bietet einen Überblick über moderne Ansätze sowie reale Fallstudien, die mit Codebeispielen ergänzt werden, um praktische Erfahrungen zu ermöglichen. Die Struktur des Buches ist in drei Teile gegliedert, die auf unterschiedliche Zielgruppen und deren Fachkenntnisse abgestimmt sind, und bietet somit sowohl Einsteigern als auch erfahrenen Fachleuten wertvolle Einblicke.74,20 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Smart Speech, Fachbücher von Peter FlumeEinen überzeugenden Vortrag zu erstellen, ist oft mit einem hohen Zeitaufwand verbunden. Durch den gezielten Einsatz von Künstlicher Intelligenz lässt sich die Vorbereitungszeit jedoch um bis zu 75 % reduzieren und die Qualität der Präsentationen gleichzeitig spürbar verbessern. In diesem Buch von Peter Flume wird erklärt, wie KI-Agenten mit rhetorischen Grundlagen so trainiert werden können, dass sie individuelle und überzeugende Redemanuskripte erstellen, in denen die eigene Rednerpersönlichkeit erhalten bleibt. Darüber hinaus werden die Grenzen der KI beleuchtet und aufgezeigt, wie diese produktiv genutzt werden können und wie KI auch bei fremdsprachigen Präsentationen eine wertvolle Hilfe ist. Die vorgestellten Methoden sind direkt anwendbar und praxisnah. Inhalte: - KI nutzen für mehr Überzeugungskraft: schnelle Strukturierung, sprachliche Optimierung, inhaltliche Tiefe - Effiziente Workflows mit KI-Tools entwickeln und einsetzen - Inhalte mithilfe von KI zielgruppenorientiert aufbereiten - Anpassung generierter Texte an den eigenen Redestil - Gezielte Vorbereitung auf Rückfragen und Einwände - Wirkung vor Publikum steigern durch Sprache und Körpersprache - Souveräner Umgang mit Rückfragen und kritischen Situationen - Aufmerksamkeit sichern durch spannende Titel und Dramaturgie - Unterschiedliche Erzählhaltungen für verschiedene Publikumstypen einsetzen - Schlagfertigkeit und Deeskalation trainieren.29,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie nutzt man Windows Speech Recognition richtig in Visual Basic?
Um Windows Speech Recognition in Visual Basic zu nutzen, müssen Sie zunächst sicherstellen, dass Sie die entsprechenden Verweise auf die Speech API in Ihrem Projekt hinzugefügt haben. Dann können Sie die SpeechRecognitionEngine-Klasse verwenden, um Spracheingaben zu erkennen und zu verarbeiten. Sie können Ereignisse wie SpeechRecognized und SpeechRecognitionRejected abonnieren, um auf erkannte oder abgelehnte Spracheingaben zu reagieren. Schließlich können Sie die RecognizeAsync-Methode aufrufen, um die Spracherkennung zu starten und auf Benutzereingaben zu warten. **
-
Wie funktioniert Speech to Text?
Speech to Text funktioniert, indem gesprochene Wörter mithilfe von Spracherkennungssoftware in Text umgewandelt werden. Dabei werden die Audiosignale des gesprochenen Textes analysiert und in Text umgewandelt. Die Software erkennt dabei Sprachmuster, Wörter und Sätze, um sie korrekt zu transkribieren. Dieser Prozess basiert auf komplexen Algorithmen und künstlicher Intelligenz, die kontinuierlich verbessert werden, um die Genauigkeit der Umwandlung zu erhöhen. Das Ergebnis ist ein geschriebener Text, der die gesprochene Sprache möglichst genau wiedergibt. **
-
Wie benutze ich Text to Speech?
Um Text-to-Speech zu verwenden, benötigen Sie zunächst eine Software oder eine App, die diese Funktion unterstützt. Öffnen Sie dann die gewünschte Textdatei oder geben Sie den Text ein, den Sie vorgelesen haben möchten. Wählen Sie die gewünschte Stimme und Sprache aus, und starten Sie die Wiedergabe. Sie können auch die Geschwindigkeit und Lautstärke der Sprachausgabe anpassen. Text-to-Speech ist eine nützliche Funktion für Menschen mit Sehbehinderungen oder für diejenigen, die sich Texte lieber vorlesen lassen möchten. **
-
Kennt jemand ein gutes Text-to-Speech-Programm?
Ja, es gibt verschiedene gute Text-to-Speech-Programme auf dem Markt. Einige beliebte Optionen sind Google Text-to-Speech, Amazon Polly und Microsoft Azure Text-to-Speech. Diese Programme bieten eine natürliche Sprachausgabe und können in verschiedenen Anwendungen wie Sprachassistenten, Vorleseprogrammen oder Barrierefreiheitstools verwendet werden. **
Ähnliche Suchbegriffe für Speech recognition
-
OEM Stylus Inteligent selfie with face recognition tracking and gesture recognition P1 black, Smartphone Halterung, SchwarzDesktop-Halter mit intelligenter Gesichts- und Gestenerkennung sowie automatischer Verfolgung. Perfekt für Aufnahmen, Live-Streaming, Vlogging und Videoanrufe. Das Produkt verfügt über eine automatische Verfolgung von Gesicht oder Körper mit KI-Technologie und kann sich horizontal um 360 Grad drehen sowie vertikal um 37 Grad neigen. Das Stossdämpfungssystem stabilisiert Videoaufnahmen und Fotos. Es ermöglicht die Montage des Smartphones sowohl im Hoch- als auch im Querformat, sodass Sie Filme und Serien ansehen, Anrufe tätigen oder Live-Übertragungen durchführen können, ohne das Smartphone ständig in der Hand halten zu müssen. Es ist sehr leicht und aus hochwertigen Materialien gefertigt, was es ideal für Gruppenfotos oder für das Reisen allein macht. Das Gerät ist mit allen iOS (10.0 oder höher) und Android (8.1 oder höher) Geräten mit einer Breite von 5-10 cm kompatibel. Es ist keine Anwendungsinstallation erforderlich. Es verfügt über einen integrierten Akku, der über den USB-C-Anschluss aufgeladen wird. Der Halter kann auf einem Stativ (1⁄4 Zoll Standard) montiert werden. Darüber hinaus verbindet sich das Stativ über Bluetooth mit einem Smartphone. Spezifikation: Konnektivität: Bluetooth v5.0 Betriebszeit: 6-12 Stunden Unterstützte Smartphone-Breite: 50-100 mm Batteriekapazität: 2000 mAh Anschluss: USB-C Kabel: USB-A zu USB-C Abmessungen: 170 x 95 x 95 mm Gewicht: 250 g.27,33 €*Versand: 3,00 €Sichere Weiterleitung zum Anbieter
-
Free Speech, Sachbücher von Timothy Garton AshDer führende politische Schriftsteller Timothy Garton Ash präsentiert zehn Leitprinzipien für die Meinungsfreiheit im digitalen Zeitalter, die das Ergebnis eines einzigartigen globalen Gesprächs sind. Nie in der Menschheitsgeschichte gab es eine so grosse Chance für die Meinungsfreiheit. Mit Internetzugang kann jeder fast alles veröffentlichen und potenziell ein Publikum von Millionen erreichen. Dies bedeutet jedoch auch, dass die Übel einer unbegrenzten Rede leicht über Grenzen hinweg fliessen können: gewalttätige Einschüchterung, grobe Verletzungen der Privatsphäre und Flutwellen des Missbrauchs. Ein Pastor verbrennt einen Koran in Florida, und UN-Beamte sterben in Afghanistan. Basierend auf einem Leben, das dem Schreiben über Diktaturen und Dissidenten gewidmet ist, argumentiert Timothy Garton Ash, dass in dieser vernetzten Welt, die er Kosmopolis nennt, der Weg, Freiheit und Vielfalt zu verbinden, darin besteht, mehr, aber auch bessere Meinungsfreiheit zu haben. Über alle kulturellen Grenzen hinweg müssen wir uns bemühen, uns darauf zu einigen, wie wir uns uneinig sind. Er stützt sich auf ein globales Online-Projekt in dreizehn Sprachen, das von der Universität Oxford durchgeführt wird und diesem Zweck gewidmet ist. Mit lebendigen Beispielen, von seinen persönlichen Erfahrungen mit Chinas orwellschem Zensurapparat bis hin zur Kontroverse um Charlie Hebdo und einem sehr englischen Gerichtsfall, der die Lebensmittelautorin Nigella Lawson betrifft, schlägt er einen Rahmen für zivilisierten Konflikt in einer Welt vor, in der wir alle Nachbarn werden. Timothy Garton Ash ist der preisgekrönte Autor von neun vorherigen politischen Büchern, darunter zuletzt "Facts Are Subversive". Er ist Isaiah Berlin Professorial Fellow am St Antony's College, Oxford, Senior Fellow an der Hoover Institution, Stanford University, und ein regelmässiger Beitragender zu verschiedenen Publikationen. Er hat mehrere Auszeichnungen für sein Schreiben erhalten, darunter den Orwell-Preis.25,93 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was ist die beste KI für Text-to-Speech?
Es gibt viele gute KI-Modelle für Text-to-Speech, aber einige der bekanntesten und am weitesten entwickelten sind Tacotron 2, WaveNet und Deep Voice. Diese Modelle haben eine hohe Qualität und Natürlichkeit in der Generierung von Sprache und werden von vielen Unternehmen und Entwicklern verwendet. Es ist jedoch wichtig zu beachten, dass die "beste" KI für Text-to-Speech von den spezifischen Anforderungen und Präferenzen abhängt, da verschiedene Modelle unterschiedliche Stärken und Schwächen haben können. **
-
Wie erstelle ich ein eigenes Text-to-Speech-Paket?
Um ein eigenes Text-to-Speech-Paket zu erstellen, benötigst du zunächst eine Sprachsynthese-Engine, die den Text in Sprache umwandelt. Du kannst eine vorhandene Engine verwenden oder eine eigene entwickeln. Anschließend musst du die Sprachdatenbank erstellen, die die Aufnahmen der Sprachausgabe enthält. Diese Datenbank kann aus Aufnahmen eines Sprechers bestehen oder durch die Kombination von vorhandenen Sprachdatenbanken erstellt werden. Schließlich musst du das Paket in einem geeigneten Format speichern, das von der gewünschten Plattform oder Anwendung unterstützt wird, z.B. als Plugin, Bibliothek oder Datei. **
-
Gibt es ein Open-Source-Text-to-Speech-Modell?
Ja, es gibt mehrere Open-Source-Text-to-Speech-Modelle. Ein bekanntes Beispiel ist das Tacotron-Modell, das von Google entwickelt wurde. Es ermöglicht die Generierung von natürlicher Sprache aus Text und ist in der Open-Source-Community weit verbreitet. Es gibt auch andere Modelle wie WaveNet und DeepVoice, die ebenfalls Open-Source sind. **
-
Wie lautet der deutsche Text-to-Speech-Stimme VBS?
Die deutsche Text-to-Speech-Stimme VBS steht für "Voices for Blind and Sight-impaired" und ist eine speziell entwickelte Stimme für blinde und sehbehinderte Menschen. Sie ermöglicht es ihnen, geschriebenen Text in gesprochene Sprache umzuwandeln und so Informationen zu erhalten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.